Il backup non è un prodotto da comprare, è una capacità da progettare: riportare dati e servizi a uno stato utilizzabile dopo un evento che li ha resi indisponibili, corrotti o sbagliati. La domanda corretta quindi non è “dove copio i file?”, ma “da quali eventi voglio recuperare, quanti dati posso perdere e quanto tempo posso restare fermo?”.
RAID, snapshot, replica e backup sono cose diverse
Quattro tecnologie vengono spesso confuse perché tutte producono “più copie” in qualche forma:
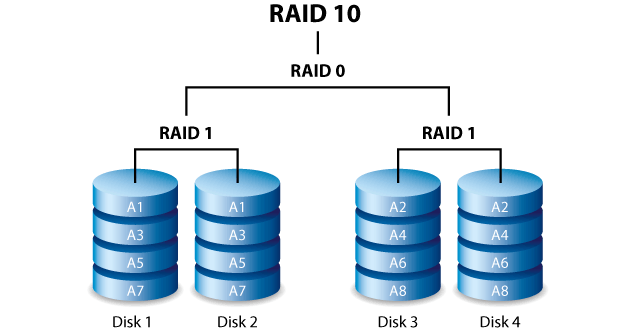
- RAID mantiene disponibile lo storage durante alcuni guasti di disco;
- snapshot fotografa velocemente lo stato di un filesystem o volume in un certo momento;
- replica mantiene una seconda copia sincronizzata, spesso quasi in tempo reale;
- backup conserva versioni recuperabili secondo una retention e deve poter sopravvivere anche alla perdita o compromissione del sistema originario.
Se cancelliamo accidentalmente una directory, una replica sincrona può cancellarla anche dall’altra parte. Se un ransomware cifra il filesystem, un RAID replica la cifratura su tutti i dischi. Per questo ridondanza e backup devono convivere invece di sostituirsi.
Prima di scegliere lo strumento: RPO e RTO
L’RPO (Recovery Point Objective) indica quanti dati possiamo accettare di perdere. Con un backup notturno, nel caso peggiore, possiamo perdere quasi un giorno di lavoro. Un database transazionale può invece richiedere RPO di minuti o secondi.
L’RTO (Recovery Time Objective) indica quanto tempo possiamo impiegare per tornare operativi. Possedere 20 TB di backup su una linea lenta può garantire un ottimo RPO ma un RTO pessimo.
Questi due valori guidano frequenza, tecnologia, banda, numero di copie e budget. Senza RPO e RTO stiamo progettando il backup al contrario.
Quali eventi dobbiamo coprire?
Una strategia completa dovrebbe almeno chiedersi come recuperare da:
- guasto di un disco o dell’intero server;
- cancellazione accidentale;
- corruzione logica scoperta dopo giorni;
- ransomware o compromissione con privilegi elevati;
- errore durante un aggiornamento o un deploy;
- perdita fisica della sede o del dispositivo di backup;
- errore umano sul sistema di backup stesso.
Ogni evento mette in crisi una strategia differente. Un NAS nella stessa stanza protegge dal guasto del server ma non necessariamente da incendio, furto o cifratura se è sempre montato con credenziali scrivibili.
La regola 3-2-1 come punto di partenza
La regola 3-2-1 è un promemoria utile: mantenere più copie dei dati, su sistemi/supporti differenti, con almeno una copia separata dalla sede o dal sistema principale. Non è una garanzia matematica, ma costringe a evitare il classico “backup” sul secondo disco dello stesso server.
Negli ambienti esposti a ransomware aggiungiamo un concetto ancora più importante: almeno una copia dovrebbe essere offline, immutable o comunque non cancellabile con le stesse credenziali della produzione.
Full, incrementale e differenziale
Un backup full contiene tutto ciò che serve per quel punto di ripristino. È semplice da recuperare ma consuma tempo e spazio. Un incrementale conserva solo ciò che è cambiato dall’ultimo backup della catena; riduce il volume quotidiano ma il restore può richiedere più passaggi. Un differenziale conserva ciò che è cambiato dall’ultimo full e rappresenta un compromesso.
Molti strumenti moderni usano deduplicazione e repository content-addressed, quindi queste categorie diventano meno visibili all’operatore. Il principio resta però lo stesso: dobbiamo sapere quante dipendenze servono per ricostruire un punto di restore e cosa succede se una parte della catena è corrotta.
Retention: il backup deve conservare il passato
Mantenere soltanto “l’ultima copia” protegge dal guasto avvenuto oggi, non dalla corruzione iniziata due settimane fa e scoperta questa mattina. La retention deve quindi conservare più punti temporali, per esempio giornalieri, settimanali e mensili, in funzione del valore dei dati e dello spazio disponibile.
La retention va anche monitorata. Un repository che cresce fino a riempire il disco può interrompere silenziosamente i backup proprio quando pensavamo di essere protetti.
Database: una copia dei file non basta
Un database attivo modifica continuamente file e pagine. Copiare a caldo la directory di MariaDB o PostgreSQL come se fosse una cartella di documenti può produrre uno stato incoerente. Usiamo quindi dump logici, snapshot coordinati o strumenti specifici del database.
# Esempio MariaDB/MySQL, adatto a tabelle transazionali
mariadb-dump   --single-transaction   --routines   --events   --triggers   database_name | gzip > database_name.sql.gz
Il dump deve finire poi dentro la stessa politica di retention e copia off-site del resto del backup.
File: preservare metadati e permessi
Su un server Linux non contano soltanto i byte. Proprietari, gruppi, ACL, extended attributes e hard link possono essere necessari per ricostruire correttamente il servizio.
# Copia locale/remota che preserva molti metadati
rsync -aHAX --numeric-ids /srv/data/ backup:/backup/server/data/

# Archivio con ACL e xattr
tar --acls --xattrs --numeric-owner -czf data.tar.gz /srv/data
--delete in rsync va usato soltanto quando sappiamo esattamente perché lo vogliamo: una sincronizzazione speculare non è automaticamente un backup versionato.
Cifrare il backup senza perdere la chiave
Una copia off-site può contenere gli stessi dati sensibili della produzione, quindi spesso deve essere cifrata. Ma la chiave di cifratura diventa parte del disaster recovery: se è conservata soltanto sul server che stiamo cercando di ripristinare, abbiamo costruito un backup perfettamente illeggibile.
Chiavi, password e procedure di recupero vanno conservate separatamente e testate con la stessa attenzione dei dati.
Un backup fallito deve fare rumore
Il job notturno non deve limitarsi a partire: deve produrre uno stato verificabile. Controlliamo exit code, spazio libero, età dell’ultima copia riuscita e dimensione ragionevole del repository. Un backup che fallisce ogni notte senza alert è solo un rituale.
# Esempi di controlli minimi
df -h /srv/backup
find /srv/backup -type f -mtime -1 | head
journalctl -u my-backup.service --since yesterday
Il restore è il vero test
Un archivio con checksum corretto dimostra che il file non è cambiato, non che l’applicazione ripartirà. Periodicamente dobbiamo ripristinare almeno una parte significativa del sistema in un ambiente isolato: database, configurazioni, certificati e applicazione.
È durante questi test che scopriamo dipendenze dimenticate, chiavi mancanti, permessi errati e procedure che esistono soltanto nella memoria di chi ha costruito il server.
Esempio di strategia per un piccolo server
- RAID1 o RAID10 per disponibilità locale, se necessario;
- backup giornaliero automatico di file e database;
- più punti di retention, non soltanto l’ultima copia;
- replica del repository verso un NAS o server differente;
- almeno una copia off-site o immutable;
- alert se il job fallisce o la copia diventa troppo vecchia;
- test di restore periodico documentato.
Per una implementazione concreta su hosting Linux puoi proseguire con Backup di un server ISPConfig. Per capire la ridondanza dei dischi, invece, la base è RAID: livelli, ridondanza e mdadm.